Prova a chiedere a un generatore di immagini AI di creare “una figura professionale che si occupa di chirurgia in una corsia di ospedale”.
Non specificare nient’altro. Non indicare genere, età, etnia. Lascia che l’AI completi i dettagli.
Ora osserva il risultato.
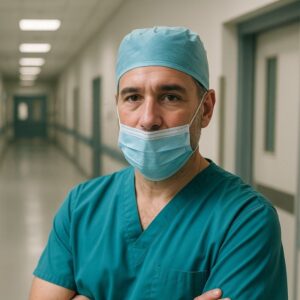
Prompt: “crea una immagine realistica rappresentando il ritratto di una figura professionale che si occupa di chirurgia in una corsia di ospedale”
Con ogni probabilità, il chirurgo è un uomo. Bianco. Di mezza età. Con un’espressione seria e competente.
Ora prova con “una figura professionale che si occupa di formazione in una scuola elementare”.
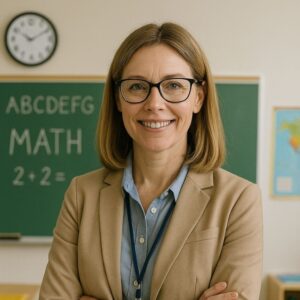
Prompt: “crea una immagine realistica rappresentando il ritratto di una figura professionale che si occupa di formazione in una scuola elementare”
Quasi certamente, l’insegnante è una donna. Giovane. Sorridente. Probabilmente bianca.
Nessuno ha chiesto all’AI di fare queste scelte. Non c’era nulla nel prompt che suggerisse un genere o un’etnia. L’AI ha “deciso” da sola, basandosi su quello che ha imparato.
E quello che ha imparato riflette i pregiudizi del mondo che l’ha addestrata.
Da dove vengono i bias
I modelli di intelligenza artificiale non nascono nel vuoto. Nascono dai dati.
Un generatore di immagini viene addestrato su milioni di fotografie, illustrazioni, dipinti raccolti da internet. Un modello linguistico viene addestrato su miliardi di pagine di testo — articoli, libri, forum, social media. Tutto questo materiale porta con sé i pregiudizi, gli stereotipi e le distorsioni della cultura che l’ha prodotto.
Se nelle immagini di addestramento i chirurghi sono prevalentemente uomini, l’AI apprende che “chirurgo” si associa a caratteristiche maschili. Se nelle descrizioni testuali gli insegnanti di scuola elementare sono prevalentemente donne, l’AI apprende questa associazione come se fosse un fatto, non uno stereotipo storico.
Il bias non è un errore del sistema. È il sistema che funziona esattamente come progettato: replicare pattern dai dati.
L’AI non “pensa” che i chirurghi debbano essere uomini. Non ha opinioni. Calcola probabilità statistiche e genera l’output più probabile dato l’input. Il problema è che “più probabile” non significa “corretto” — significa “più frequente nei dati di addestramento”.
Un esperimento che chiunque può fare
La forza di questo tipo di bias è che è verificabile da chiunque, in qualsiasi momento. Non servono competenze tecniche, non servono strumenti speciali. Basta un generatore di immagini AI e qualche prompt.
Prova a generare “una coppia di innamorati seduta su una panchina in un parco pubblico”.
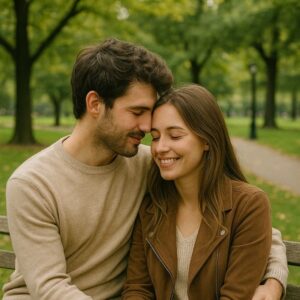
Prompt: “crea una immagine realistica rappresentando una coppia di innamorati seduti su di una panchina in un parco pubblico”
Osserva: la coppia è quasi certamente eterosessuale. Probabilmente bianca. Probabilmente giovane. Il parco probabilmente assomiglia a un parco europeo o nordamericano.
Niente di tutto questo era specificato nel prompt. L’AI ha riempito i vuoti con le associazioni più frequenti nei suoi dati di addestramento. E quei dati riflettono una visione del mondo — non l’unica possibile, non necessariamente quella corretta.
Prova con “una persona facente parte di un ordine religioso”.
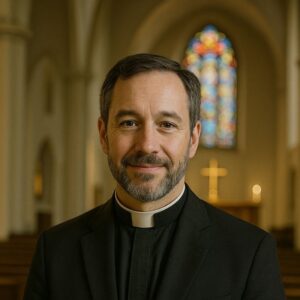
Prompt: “crea una immagine realistica che rappresenti una persona facente parte di un ordine religioso”
Quale religione ha generato? Con quali caratteristiche? L’output racconta molto di più sui dati di addestramento che sulla realtà del mondo religioso.
Perché questo è un problema
Potresti pensare: “Va bene, l’AI ha dei pregiudizi. Sono immagini generate, che importanza ha?”
L’importanza sta nell’uso che facciamo di questi sistemi, e nella scala a cui operano.
Nelle assunzioni. Sistemi AI vengono usati per filtrare curricula, analizzare candidati, suggerire assunzioni. Se il sistema ha appreso che “leader” si associa a caratteristiche maschili, tenderà a valutare più positivamente candidati uomini per ruoli di leadership. Amazon ha dovuto ritirare un sistema di screening CV nel 2018 proprio per questo motivo: il sistema penalizzava automaticamente i curriculum che contenevano parole come “women’s” (ad esempio, “women’s chess club captain”).
Nella sanità. Algoritmi diagnostici vengono addestrati su dati che sovra-rappresentano alcune popolazioni e sotto-rappresentano altre. Il risultato è che le diagnosi sono più accurate per i gruppi più rappresentati nei dati — e meno accurate per tutti gli altri.
Nella giustizia. Sistemi di valutazione del rischio vengono usati per decisioni su cauzione, condanne, libertà vigilata. Se i dati storici riflettono disparità nel sistema giudiziario, l’AI perpetua e amplifica quelle disparità.
Nei contenuti generati. Ogni immagine, testo, video prodotto dall’AI porta con sé i bias dei dati di addestramento. Quando questi contenuti vengono pubblicati e condivisi, rinforzano gli stereotipi esistenti. Creano un ciclo: i bias nei dati producono contenuti distorti, i contenuti distorti diventano nuovi dati, i nuovi dati rinforzano i bias.
L’illusione dell’oggettività
C’è una pericolosa tendenza a considerare l’AI come oggettiva.
“La macchina non ha pregiudizi” — questo si sente dire. “L’algoritmo è neutrale, sono i numeri che parlano.”
È falso. Profondamente, strutturalmente falso.
L’AI è il prodotto dei suoi dati di addestramento e delle scelte di chi l’ha progettata. I dati sono raccolti da esseri umani, con tutti i loro pregiudizi consci e inconsci. Le scelte di progettazione — cosa ottimizzare, come pesare i diversi fattori, quali metriche usare — sono fatte da esseri umani, con le loro priorità e visioni del mondo.
L’AI non elimina i pregiudizi umani. Li codifica, li scala, li automatizza.
E li rende più difficili da vedere e contestare. Quando una persona prende una decisione discriminatoria, possiamo identificarla e contrastarla. Quando un algoritmo prende la stessa decisione, si nasconde dietro un’apparenza di neutralità matematica.
Cosa si sta facendo
L’industria dell’AI è consapevole del problema — almeno nelle sue componenti più responsabili.
Audit dei bias. Aziende come Google, OpenAI e Anthropic conducono test sistematici per identificare i bias nei loro modelli prima del rilascio. Cercano di misurare come il sistema risponde a prompt che coinvolgono genere, etnia, religione, orientamento sessuale.
Diversificazione dei dati. Si lavora per rendere i dataset di addestramento più rappresentativi della diversità reale del mondo. Questo significa includere intenzionalmente immagini e testi che rappresentano gruppi storicamente sotto-rappresentati.
Filtri e guardrail. I sistemi commerciali includono filtri che cercano di bloccare output apertamente discriminatori. Questi filtri non eliminano il bias sottostante — lo mascherano a livello di output.
Trasparenza. Alcune aziende pubblicano “model card” che documentano i limiti noti dei loro sistemi, inclusi i bias identificati. Questo permette agli utenti di fare scelte informate.
Nessuna di queste soluzioni è definitiva. Il bias è un problema strutturale che richiede interventi strutturali — non solo tecnici, ma culturali, organizzativi, normativi.
Cosa puoi fare tu
Come utente di sistemi AI, hai più potere di quanto pensi.
Consapevolezza. Il primo passo è sapere che il problema esiste. Quando usi un generatore di immagini, un assistente testuale, un sistema di raccomandazione, ricorda che l’output riflette i bias dei dati di addestramento. Non trattarlo come verità oggettiva.
Verifica. Quando l’output riguarda persone, gruppi, culture, chiediti: “Questo riflette la realtà o uno stereotipo?” Fai test con prompt simili che variano solo per genere, etnia, età. Osserva le differenze.
Compensazione. Se usi AI per creare contenuti, considera attivamente la diversità. Specifica nei prompt quando vuoi rappresentazioni che escano dagli stereotipi. Controlla e correggi l’output prima di pubblicarlo.
Segnalazione. La maggior parte delle piattaforme AI ha meccanismi per segnalare output problematici. Usali. I feedback degli utenti sono uno degli strumenti più importanti per migliorare i sistemi.
Scelta. Supporta aziende e prodotti che prendono sul serio il problema dei bias. La pressione del mercato è uno dei motori più efficaci del cambiamento.
La responsabilità condivisa
L’AI non è neutrale. Non lo è mai stata. Non lo sarà finché sarà il prodotto di dati e scelte umane.
Questo non significa che dobbiamo smettere di usarla. Significa che dobbiamo usarla con occhi aperti, consapevoli dei suoi limiti e delle sue distorsioni. Significa che chi sviluppa questi sistemi ha la responsabilità di minimizzare i danni. E significa che chi li usa ha la responsabilità di non amplificarli.
La prossima volta che chiedi all’AI di generare un’immagine, pensa a cosa non hai specificato. Pensa a come l’AI riempirà quei vuoti. E chiediti se il risultato riflette il mondo come è, il mondo come era, o il mondo come qualcuno pensa che dovrebbe essere.
La differenza sta tutta lì.